
摘要
大型语言模型(LLM)已从根本上改变了密集检索,将其骨干网络从判别式编码器升级为生成式架构。然而,一个关键的脱节仍然存在:虽然LLM具备强大的推理能力,但当前的检索器主要将它们用作静态编码器,其复杂推理的潜力尚未被开发。为了解决这个问题,现有方法通常采用“重写-然后-检索”的流程,在检索前生成显式的思维链(CoT)推理过程。然而,这会导致难以承受的延迟。相反,利用潜在令牌(Latent Tokens)的隐式推理方法虽然高效,但由于缺乏显式监督,常常遭受语义退化的困扰。在本文中,我们提出了LaSER,一个新颖的自蒸馏框架,它将显式推理内化到密集检索器的潜在空间中。LaSER 在一个共享的LLM骨干网络上运行,引入了一种双视图训练机制:一个显式视图,显式地编码真实的推理路径;以及一个潜在视图,执行隐式的潜在思考。为了弥合这两个视图之间的差距,我们设计了一种多粒度对齐策略。除了标准的输出对齐之外,我们还引入了一种轨迹对齐机制,该机制将潜在路径的中间潜在状态与显式推理片段的语义进展同步。这使得检索器能够“静默”且有效地“思考”,而无需进行自回归文本生成。在领域内和领域外的推理密集型基准测试上的大量实验表明,LaSER显著优于最先进的基线模型。此外,跨不同骨干网络和模型规模的分析验证了我们方法的鲁棒性,证实了我们统一的学习框架对于引发有效的潜在思考至关重要。我们的方法成功地将显式CoT流程的推理深度与标准密集检索器的推理效率结合起来。
1 引言
密集检索已发展成为现代信息检索(IR)系统的基本组成部分,广泛应用于网络搜索、问答系统 [16, 42] 和检索增强生成(RAG)系统 [10, 20]。这些检索器通过在共享嵌入空间中进行语义匹配,有效地弥合了词汇不匹配的差距 [16, 35, 40]。随着大型语言模型(LLM)[1, 47, 49] 的出现,该领域见证了一个关键的范式转变:检索器骨干网络正从小规模的判别式模型(如BERT、RoBERTa)过渡到大规模的生成式LLM [21, 36]。最先进的基于LLM的检索器 [19, 40, 46] 相比其前代产品,展现出了优越的语义理解能力。虽然基于LLM的检索器已经展现出卓越的语义理解能力 [4, 36, 46],但一个悖论仍然存在:虽然这些检索器继承了底层LLM的庞大知识和推理潜力,但它们主要通过对比学习进行训练,以优化表示的区分性 [15]。这种训练目标在很大程度上使得生成架构固有的推理能力处于休眠状态,仅仅将LLM视为一个更强的编码器,而非推理器 [30, 32, 34]。
这种局限性在处理复杂的用户查询时变得尤为明显。现实世界的搜索场景通常涉及隐含意图 [26, 48]、多跳逻辑 [13, 42] 或模糊描述 [25, 39],这些都需要超越表面语义匹配的推理。为了弥合这一差距,一种流行的解决方案采用了“重写-然后-检索”的流程 [9, 41],利用外部LLM在检索前显式地生成查询扩展或思维链(CoT)推理过程 [7, 33, 38, 43, 45]。虽然这种方法在提升性能方面很有效,但它们依赖于冗长的自回归生成,造成了难以承受的延迟瓶颈 [11](如图1所示)。为了缓解这些延迟问题,最近的研究探索了隐式推理方法,允许检索器在生成最终表示之前,在嵌入空间内生成“潜在思考令牌” [34]。虽然这种方法很有前景,但它们面临一个关键挑战:缺乏显式的语义监督。仅依靠最终的对比学习损失,生成的潜在令牌通常缺乏足够的指导,无法准确捕获检索所需的关键信息,特别是对于涉及推理的查询而言。
我们认为,解决这一困境的关键在于内化:利用LLM的显式推理能力作为特权监督,来指导检索器的轻量级潜在思考。我们的核心见解是,虽然在推理过程中生成显式CoT效率低下,但这些推理路径所承载的语义是无价的。我们不将显式和隐式推理视为独立的范式,而是提议在一个统一的框架内对齐它们,允许检索器在潜在空间中“静默”思考。受此洞察驱动,我们提出了一个双视图框架,其中模型学习将显式推理能力内化到潜在空间中。显式视图学习将推理逻辑编码为嵌入,充当语义上界。潜在视图生成潜在思考令牌,以模拟内部的推理过程。
为了有效地将推理能力从显式视图转移到潜在视图,我们引入了一种多粒度对齐策略。我们不仅对齐最终的查询表示(输出对齐),还对中间潜在状态应用辅助监督(轨迹对齐),鼓励潜在令牌捕获显式CoT的语义进展。该框架提供了显著的通用性。在训练期间,显式视图充当语义教师;在推理期间,LaSER 以简化模式运行,使用潜在推理,消除了文本生成的需要,同时保持了与计算密集型流程方法相当的性能。我们在一个全面的嵌入基准测试套件上评估LaSER,重点关注推理密集型任务,如Bright [32]、BrowseComp-Plus [6] 和 FollowIR [39]。实证结果表明,我们的方法通过在推理过程中仅引入少量潜在令牌,显著增强了检索性能,避免了自回归解码的延迟。此外,LaSER 始终优于现有的显式和隐式推理基线。值得注意的是,在某些推理密集型场景中,它甚至达到了优于依赖外部LLM进行查询重写的计算密集型流程的性能,验证了我们提出的蒸馏机制的有效性。
我们的主要贡献总结如下:
- 我们提出了 LaSER,一个统一的检索框架,通过在共享骨干网络内进行自蒸馏,弥合了显式CoT推理和隐式潜在思考之间的差距。
- 我们设计了一种双视图对齐机制,包括输出级和过程级的轨迹对齐,该机制有效地将推理语义蒸馏到潜在令牌中,并防止了隐式推理模型中经常观察到的退化现象。
- 大量的实验表明,LaSER 在不同的骨干架构和模型规模上始终优于基线,有力地验证了我们提出的自蒸馏机制的有效性。
- 我们通过实验验证了显式推理路径的语义可以有效地蒸馏到潜在空间中。这使得 LaSER 能够达到与计算密集型的“重写-然后-检索”流程相当的性能,同时保持标准密集检索器的推理效率。
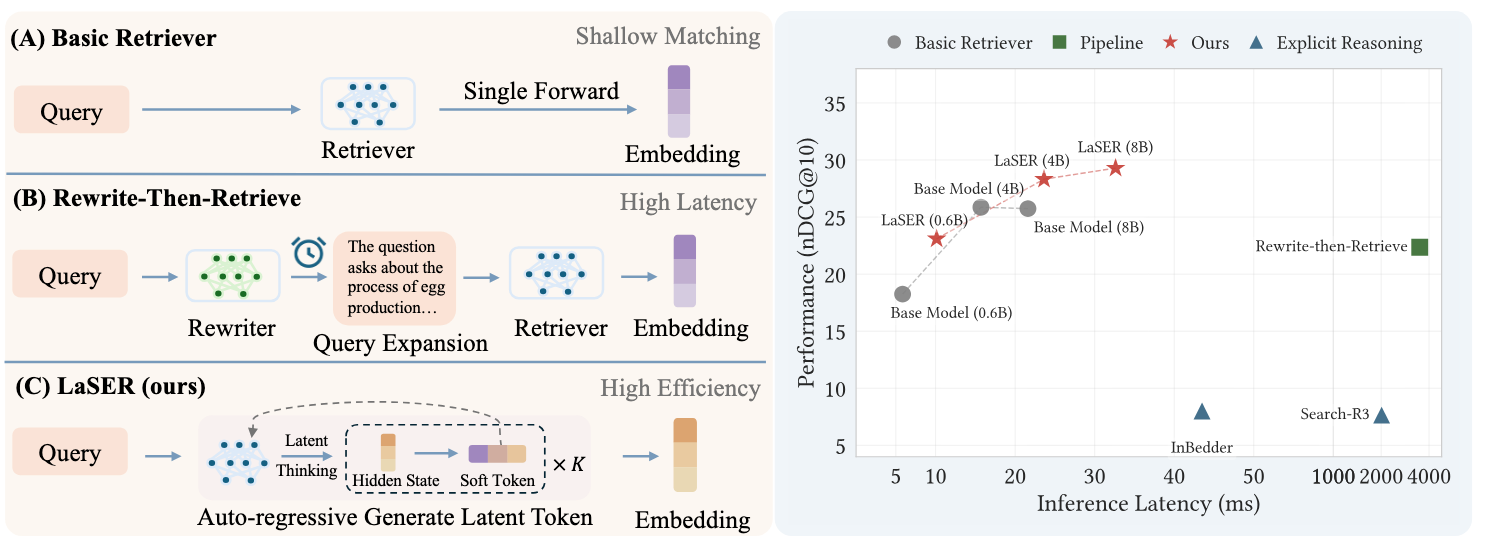
图1:左图:我们提出的流程与常规检索器和重写-然后-检索方法的比较。右图:不同方法在Bright基准上的性能和延迟比较。延迟代表处理单个查询的时间消耗。“重写-然后-检索”方法使用一个0.6B的检索器和一个3B的检索器。
2 相关工作
2.1 基于LLM的检索与查询扩展
密集检索的范式已从小规模的判别式骨干网络(如BERT [17])显著转向大规模的生成式LLM [36, 46]。通过利用LLM固有的广泛世界知识和语义理解能力,这些检索器在标准语义匹配中实现了优越的性能。然而,它们仍然主要依赖对比学习目标,这通常在处理需要深度推理或意图消歧的复杂查询时遇到困难。为了弥合这一差距,“重写-然后-检索”流程变得普遍(如图1所示),它利用外部LLM在检索前扩展查询 [9, 37] 或生成推理过程 [3, 29]。虽然这种方法很有效,但它将推理与检索解耦,由于自回归解码引入了显著的延迟,并使系统部署复杂化。与这些多阶段流程不同,我们的工作旨在将重写和推理能力直接内化到检索器的参数中,保留单阶段双编码器的推理效率,同时保留生成式扩展的语义优势。
2.2 检索中的推理
最近的研究探索了将推理能力直接集成到检索系统中,大致可分为以数据为中心 [8, 23, 40] 和以机制为中心的方法。以数据为中心的方法通过合成推理密集型的查询及其对应的难负例来增强检索。相反,以机制为中心的方法修改检索器的架构以支持推理,进一步分为显式和隐式策略。显式方法利用检索器本身在产生最终嵌入之前生成自然语言的CoT推理过程 [7, 11, 28, 33, 43]。虽然这种方法提高了可解释性,但它通过要求模型同时学习两个任务而使训练复杂化 [27]。此外,它遭受着与外部重写相同的计算瓶颈。隐式推理则通过在嵌入空间内生成“潜在思考令牌” [34] 或多向量表示 [2] 来模拟这一过程,这些表示在不生成可见文本的情况下捕获查询的细微差别。尽管它们效率很高,但现有的隐式方法主要依赖最终的对比损失进行监督,这在捕获复杂查询语义方面构成了瓶颈,并阻碍了进一步的性能提升。我们的框架通过使用显式CoT作为特权监督器来解决这一局限性,将显式推理路径的语义蒸馏到潜在令牌中,以确保隐式过程在语义上是有意义的。
2.3 IR中的知识蒸馏
知识蒸馏(KD)被广泛用于将能力从强大的教师模型转移到高效的学生模型 [24],在IR中通常分为输出级和特征级蒸馏。输出级蒸馏通常利用LLM生成合成训练数据,例如查询扩展或伪相关标签 [46],学生模型模仿这些数据。特征级蒸馏侧重于对齐连续表示,通常训练学生检索器以逼近强大教师模型的隐藏空间或相关性分数 [22, 44]。关键在于,这些方法是面向结果的:它们改善了相关性信号,但并未根本改变学生的信息处理机制。与这种范式不同,我们从LLM潜在推理 [5, 12, 31] 中汲取灵感,将显式推理步骤内化为潜在状态 [34]。我们不仅仅蒸馏相关性分数,而是利用显式的思维链作为“真实”逻辑来监督潜在思考。据我们所知,LaSER 是第一个在密集检索中应用显式到潜在推理蒸馏的工作。
3 方法
在本节中,我们介绍 LaSER,一个旨在将显式推理能力内化到密集检索器潜在空间中的统一框架。我们首先阐述检索问题并给出我们框架的概述。然后,我们详细介绍我们框架的训练过程和优化目标,重点介绍我们的多粒度自蒸馏机制。
3.1 问题定义
给定一个用户查询 和一个候选文档集 ,密集检索的目标是学习一个编码器 ,将文本输入映射到一个 维的嵌入空间 。查询 和文档 之间的相关性分数通常通过它们的嵌入 和 的余弦相似度来计算,即 。
在标准的基于LLM的检索器中,查询表示通过单次前向传递获得。为了增强指令跟随能力,通常会在 前加上特定于任务的指令 。然后在输入序列后附加一个 [EOS] 令牌,并提取该令牌对应的最后一层隐藏状态作为嵌入:
然而,这种浅层处理通常无法捕获推理密集型查询所需的复杂隐含意图。
为了解决这个问题,现有的“重写-然后-检索”方法引入了一个外部LLM推理器 来生成显式的推理路径 ,然后检索器编码这个丰富的上下文:
虽然 捕获了更深的语义,但自回归生成文本 会带来难以承受的延迟和部署成本。
在这项工作中,我们旨在通过训练模型执行潜在推理来弥合这一差距。模型不再生成显式文本 ,而是在嵌入空间内自主生成一个由 个连续潜在思考令牌 组成的序列。最终的查询表示 源自这些潜在状态,旨在逼近 的语义深度,同时保持单模型架构的效率。
3.2 框架概述
如图2所示,LaSER 构建在一个具有因果注意力的统一生成式LLM骨干网络之上。为了实现推理能力的内化,我们采用了一种双视图训练范式,其中模型通过两个共享相同参数 的对齐视角进行学习:
-
显式视图(Explicit-View):该视图在训练期间充当语义上界。它接收由高级推理器生成的高质量、显式CoT推理过程增强的查询。通过对这个丰富上下文执行单次前向传递,显式视图获得一个综合了原始查询和显式推理路径的表示。
-
潜在视图(Latent-View):该视图作为推理的目标模式。它仅接收原始查询作为输入,并在生成最终查询表示之前,在潜在嵌入空间中生成一个潜在思考令牌序列。我们设计了一个自蒸馏框架来促进这两个视图的协同训练,特别是潜在视图,详见第3.5节。
-
推理(Inference):在推理期间,LaSER 仅在潜在视图模式下运行。它利用学到的潜在思考令牌来编码查询,确保延迟与标准密集检索器相当,同时受益于内化的推理能力。可选地,模型保留了接受来自外部LLM的重写查询的灵活性,以进一步适应不同的部署场景。
3.3 潜在视图
潜在视图的主要目标是在避免与显式文本生成相关的延迟开销的同时,增强模型处理复杂查询的推理能力。受连续推理最新进展的启发,我们提出了一种机制,其中由 参数化的编码器模型在连续嵌入空间内执行“思考”。这种方法用自回归的连续思维向量序列取代了离散的令牌生成,允许模型以完全可微分的方式细化其对查询意图的理解。
如图2所示,给定一个输入查询 ,模型首先将离散的令牌序列映射为密集嵌入 ,其中 是嵌入矩阵, 是词汇表大小。骨干LLM 处理此序列以产生初始隐藏状态。

图2:LaSER 的示意图。在训练期间,每一步涉及两个推理路径:显式视图和潜在视图(如左图所示)。这两个路径的输入不同,显式视图包含额外信息。然而,在推理阶段,仅使用潜在视图模式。损失函数根据两个路径的结果计算(如右图所示)。
为了促进潜在推理,我们用一个由 个潜在思考令牌 组成的序列来扩展查询。与采样离散索引的标准解码不同,我们将这些令牌构建为连续向量,以保留语义丰富性和可微性。该过程以自回归方式进行:在第 个思考步骤 ,令 为骨干网络输出的最后一个隐藏状态。我们通过语言建模头 将 投影到词汇空间,以获得对数几率 :
我们不执行硬选择(例如,arg max),而是计算词汇表上的概率分布 。软潜在令牌 然后被计算为该分布下的期望嵌入向量:
这个软令牌 被附加到下一步的输入序列中。模型以自回归方式运行,其中第 步的输入包括原始查询和所有前面的潜在令牌:
其中 代表隐藏状态的序列。通过因果注意力机制,每个潜在令牌 可以关注查询上下文和之前的思考步骤,模仿显式思维链推理的顺序逻辑。
在 步之后,我们获得一个推理状态序列 。为了将这个推理过程的全局语义综合成一个统一的表示,我们对这些状态应用均值池化,以导出最终的查询向量 :
文档 的表示也以相同方式获得。此潜在思考过程保持严格的自回归性,确保与KV缓存优化完全兼容。此外,通过限制推理范围 (通常 ),该方法实现了与标准密集检索器相当的推理延迟,显著优于需要解码长文本链的生成式方法。
3.4 显式视图
显式视图充当语义教师,通过来自高级外部推理器的特权知识来学习显式推理过程。具体来说,对于每个查询 ,我们提示外部推理器生成一个全面的CoT推理过程 ,其中包括中间推理逻辑和对查询背后潜在意图的理解(详细提示见下方引用框)。我们通过连接原始查询 、生成的推理过程 和 [EOS] 令牌来构建增强的输入序列 :
然后,模型如公式2所示编码这个增强的输入。由于显式视图和潜在视图的输入不同,两个任务之间不存在相互干扰。由于推理逻辑被明确包含在文本输入中,编码器仅执行单次前向传递,并获取最后一个隐藏状态作为最终表示 ,如公式 (2) 所示。鉴于显式路径本身可以提供中间信号,我们还提取序列中某些中间令牌的隐藏状态来表示中间的推理过程(如图2所示)。这些细节将在第3.5.3节中讨论。
用于生成推理路径的提示词示例:
- 识别核心问题。
- 逐步思考,推理并详细描述哪些信息可能与回答问题相关且有帮助。
- 尽可能多地构思答案。给定问题:[问题开始], [原始查询], [问题结束]
3.5 通过自蒸馏进行优化
为了将推理能力从显式视图转移到潜在视图,我们提出了一个结合对比学习和多粒度蒸馏的联合训练目标。
3.5.1 对比训练
两个视图都必须学习基本的判别信号。我们对两个视图都使用标准的InfoNCE损失 [15],并使用真实的正确文档 和负例 。对于潜在视图:
其中 是批次大小, 是温度超参数。使用 为显式视图计算类似的损失 。
3.5.2 输出级蒸馏
为了确保潜在视图有效地内化显式推理能力,我们从显式视图向潜在视图蒸馏语义知识。我们不严格对齐查询嵌入 和 (考虑到原始输入和推理增强输入之间固有的信息差距,这可能会过度约束潜在视图),而是采用基于分数的蒸馏策略。这种方法侧重于传递显式视图所封装的排序偏好。形式上,对于一个查询 和一个文档批次 ,我们对齐从两个视图得出的相关性分数的概率分布。
令 和 分别表示教师和学生的相似度分数。我们应用带有蒸馏温度 的softmax函数来获得概率分布:
输出级蒸馏损失随后被定义为这两个分布之间的Kullback-Leibler (KL) 散度:
通过最小化 ,潜在视图学习模仿显式视图中文档相关性的细粒度信息,有效地捕获推理增强的判断逻辑,而无需完全相同的嵌入坐标。
3.5.3 过程级轨迹对齐
仅依赖输出对齐通常将推理过程视为黑箱,这可能导致潜在令牌退化,无法编码有意义的中间语义。为了防止这种情况,我们引入了一种轨迹对齐机制,以明确监督中间的思考步骤。
我们的设计基于这样一个假设:潜在令牌序列应该作为冗长显式CoT的压缩语义轨迹。虽然显式推理过程 由可变长度的逻辑片段 (其中 是推理步骤数)组成,但潜在视图以固定的 个令牌预算运行。由于通常 ,我们假设每个潜在令牌 应对应于显式推理路径中的一个特定语义关键帧。为了实现这一点,我们采用时间下采样策略来对齐两个视图的粒度。我们通过均匀采样将第 个潜在步骤映射到对应的显式片段索引 :
这种映射确保模型将其潜在思考与显式推理链的语义进展同步。然后,我们通过最小化它们投影到文档批次上的分布之间的KL散度来对齐中间状态:
其中 表示对文档批次的softmax函数。通过强制这种对齐,我们确保潜在令牌不会漂移,而是充当严格逼近显式推理逻辑的语义检查点。
3.5.4 总体目标
最终的训练目标是各部分的加权和:
其中 是用于平衡任务的超参数。
4 实验设计
4.1 数据集与评估指标
为了提升模型的推理能力,我们使用来自 ReasonEmb [3] 的合成数据集进行训练,该数据集包含跨越12个领域的81k个训练样本。每个训练查询都附带一个由 GPT-4o-mini [14] 作为推理器生成的推理路径,该路径作为我们显式视图中的显式输入。
对于评估,我们选择了三个需要深度推理的基准:Bright [32]、FollowIR [39](领域外)和 BrowseComp-Plus [6](领域外)。遵循标准实践,我们对 BRIGHT 报告 nDCG@10,对 BC-Plus 报告 Recall@5、Recall@100 和 Recall@1000。对于 FollowIR,每个子集的评估包括一个标准指标以及 p-MRR,这是一个用于评估指令跟随能力的成对指标。遵循官方协议,除了 p-MRR,我们还对 Robust’04 和 Core’17 子集报告 MAP@5,对 News’21 子集报告 nDCG@5。
训练数据集和评估数据集的统计信息见表2。
4.2 基线模型
我们将 LaSER 与四类基线方法进行比较。为确保严格比较,除非另有说明,所有可训练的基线都使用与我们方法相同的骨干网络和训练数据。
表2:实验中使用的数据集统计信息。“Q”和“C”分别表示查询和语料库。“Len.”表示平均令牌数。“Reas. Len.”表示由外部LLM标注的平均推理长度。

标准密集检索器: 我们包括了最先进的基于编码器的模型,如 BGE-M3 [4] 和 E5-Large-Instruct [35],以及基于LLM的检索器,包括 E5-Mistral [36] 和 Qwen3-Embedding [46]。此外,我们在我们的复合数据集上训练了一个“公平基线”,使用标准的对比学习,以隔离归因于我们架构的性能提升。
流程方法(重写-然后-检索): 这类方法在检索前使用外部LLM显式地重写查询。我们利用 BGE-Reasoner-Rewriter-7B [3] 生成重写后的查询,作为检索器(使用公平基线模型)在推理期间的输入。
显式推理方法: 这些方法在一个单一模型中集成生成和检索,在输出表示之前生成一个显式的CoT。我们与 Search-R3 [11] 和 GRACE [33] 进行了比较。由于某些基线的训练代码未公开,我们使用它们的官方检查点进行推理。
隐式推理方法: 我们与 GIRcSE 进行了比较,这是一种代表性方法,它在产生最终嵌入之前也使用潜在令牌来建模推理步骤。
4.3 实现细节
我们使用 Qwen3 系列(0.6B, 4B, 8B)和 LLaMA 3.2 系列(1B, 3B, 8B)的基础版本进行实验。由于 LLaMA 3.2 没有提供 8B 变体,我们使用 LLaMA 3.1-8B 来评估该规模下的性能。所有模型都使用 LoRA 在 4 张 A100 GPU 上微调 1 个 epoch,全局批次大小为 8(每设备批次大小设为 2,并执行 8 步梯度累积)。我们使用 AdamW 优化器,学习率为 1e-4,预热比例为 0.1。每个查询配对一个难负例和批次内负例进行训练。训练期间查询和文档的最大序列长度设为 512,测试时扩展到 8192 以适应更长的上下文。为了容纳显式视图处理的显式推理路径,我们在训练期间将该视图的最大序列长度设为 1024。对比损失 和蒸馏损失 的温度超参数均设为 0.02。为了平衡多任务目标,我们设置损失权重如下:,,。潜在思考步骤数 在训练和推理阶段均设为 3。
5 结果
在本节中,我们展示 LaSER 的实验结果,随后进行详细的消融研究和效率分析。我们的评估旨在回答以下三个研究问题:
- RQ1:与使用标准对比学习的公平基线和其它训练方法相比,我们提出的框架表现如何?
- RQ2:我们提出的多粒度自蒸馏策略的影响是什么?
- RQ3:与其它基线方法相比,LaSER 能否在检索性能和延迟之间实现更优的权衡?
5.1 主要结果
在本节中,我们对 LaSER 在领域内推理基准(BRIGHT)和领域外基准(FollowIR 和 BrowseComp-Plus)上的性能进行全面分析。为了确保公平比较,我们使用相同训练数据复现了所有方法的公平基线,并基于两种不同架构在三种模型规模上进行了实验。主要结果报告在表3和表4中(完整参数规模的实验详见第5.3节)。我们的关键观察总结如下。
LaSER 相较于标准密集检索器展现出显著提升。 首先,LaSER 相较于使用标准对比学习训练的公平基线展现出显著提升。如表3所示,LaSER (Qwen3-8B) 实现了 29.3 的平均 nDCG@10。这一性能不仅超过了原始的 Qwen3-Embedding-8B (14.0),也超过了微调后的公平基线 (25.7),提升了约 15%。这一显著的性能差距表明,使用传统检索器架构的标准对比训练不足以处理复杂的推理任务,因为它未能利用模型潜在的推理能力。通过将推理内化到潜在空间,LaSER 有效地激活了 LLM 骨干网络的推理能力,弥合了浅层语义匹配与复杂推理之间的差距。
LaSER 达到了与显式流程上界相当的性能。 我们工作的一个关键动机是在不产生高延迟成本的情况下,达到与计算繁重的“重写-然后-检索”流程相匹配的性能。实验结果表明,在 Qwen3-0.6B 和 Qwen3-8B 骨干网络上,我们的方法都优于基于查询重写的显式推理方法(分别超过它们 0.7 和 1.2 个点)。此外,LaSER 显著优于需要生成多个思考令牌的显式推理模型,如 Search-R3 和 InBeddler。关键在于,LaSER 仅使用少量潜在令牌就实现了这一具有竞争力的性能,从而避免了与解码长显式CoT推理过程相关的过高计算成本。这验证了我们的核心见解:推理路径的语义可以通过自蒸馏有效地压缩到潜在状态中。使用合适的骨干网络,我们的方法能更有效地激发模型固有的推理能力,从而获得优越的性能。
LaSER 优于现有的隐式推理方法。 我们进一步将 LaSER 与最先进的隐式推理方法(特别是 GIRCE)进行了比较。在涉及不同模型规模和数据集的 9 个实验设置中,LaSER 在 8 个案例中优于 GIRCE。鉴于两种方法使用相同的输入上下文和计算预算,这些结果突显了我们提出的自蒸馏框架的有效性。这表明从教师模型集成监督显著有助于潜在思考的学习。与仅依赖输出对比信号的 GIRCE 不同,LaSER 采用了一种双对齐策略,结合了过程级和输出级蒸馏,以确保中间潜在令牌捕获更丰富的语义信息。
表3:在 Bright 基准上的主要检索性能。我们报告所有子集的 nDCG@10。相同骨干网络设置下的最佳结果以粗体显示,次优结果以下划线显示。 表示在推理期间使用外部LLM重写查询的流程方法。

表4:在 FollowIR 和 BrowseComp-Plus 上的检索性能。Columns under Robust04, News21, and Core17 belong to the FollowIR benchmark.

5.2 消融研究
为了解决 RQ2,我们使用 Qwen3-0.6B 作为骨干网络进行了全面的消融研究。鉴于 LaSER 作为一个旨在内化显式推理的自蒸馏框架,我们的分析集中在两个关键维度:
(1) 架构有效性。 我们检验了双视图结构和潜在思考机制的贡献。
- w/o Explicit View:完全移除显式视图分支,仅依赖对比损失训练学生模型进行潜在推理,没有特权监督。
- w/o Latent View:用标准的单次前向传递替换潜在推理机制以获得最终嵌入,评估即使在缺少潜在令牌的情况下,共享骨干网络学习是否也有益于标准架构。
(2) 学习策略有效性。 我们隔离了协同学习范式和我们对齐目标的影响。
- w/o Process KD:排除轨迹对齐损失 ,隔离监督中间潜在状态的影响。
- w/o Output-level Distillation:移除最终输出对齐损失 ,仅保留过程级监督。
- w/o Co-Learning:用两阶段过程替换在线自蒸馏,其中固定的显式视图教师(离线微调)生成静态监督标签,验证我们动态共享骨干网络训练的有效性。
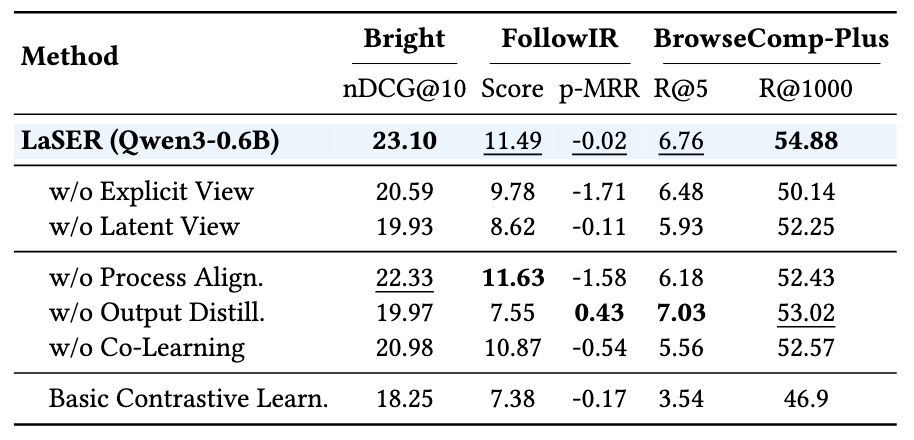
架构有效性。 我们首先验证了所提出的潜在推理机制的必要性。如表5所示,移除潜在视图导致了最显著的性能下降(例如,在 Bright 上从 23.10 降至 19.93)。这表明标准密集检索器固有的单向量输出形式造成了表示瓶颈,限制了推理能力,并阻碍了模型有效吸收教师输入提供的额外信息。相比之下,我们的潜在思考令牌成功地扩展了语义容量。我们还检验了显式教师的作用。移除显式视图同样损害了性能。这表明没有显式CoT监督,中间潜在令牌的学习效果会减弱,很可能是因为缺少显式的语义指导。
多粒度对齐的影响。 我们进一步分析了学习策略的有效性。实验结果表明,输出级和过程级蒸馏都是必不可少的;移除任一组件都会显著损害跨任务的推理能力和泛化性能。值得注意的是,排除输出蒸馏会导致更明显的下降,这证实了从教师那里传递细粒度的排序偏好是学生有效学习的先决条件。我们还观察到在线学习具有显著影响。在领域内和领域外数据集上,允许教师动态学习都产生了更优的结果。这验证了我们的共享骨干网络设计促进了视图之间更好的相互适应(该主张的进一步分析见第5.6节)。
表5:我们提出方法的消融研究。对于 FollowIR,我们报告所有子集的平均分数。
5.3 鲁棒性分析
我们验证了 LaSER 在不同骨干架构上的鲁棒性,关键观察有两点:
相较于基线的持续优越性。 我们在 Bright 上使用各种骨干模型进行了实验。如图3所示,LaSER 在所有 6 种设置中,跨不同模型系列,都保持了对所有基线的持续优越性。值得注意的是,在轻量级骨干网络(例如,0.6B 和 1B)上,LaSER 展现了卓越的有效性(23.10),甚至超过了计算密集的重写流程(22.35)。这表明我们的自蒸馏框架使小模型能够有效“思考”,而无需外部推理器的开销。
仅使用对比学习的潜在思考的不稳定性。 我们观察到,仅依赖对比学习目标的 GIRCSE 在不同架构上表现出不稳定性。在某些设置中(例如,LLaMA3.2-3B),与标准检索器基线相比,它甚至导致性能下降,而在其他设置中仅显示出微小的改进。相比之下,通过引入蒸馏信号,我们的方法在相似的架构上实现了显著的性能提升。这表明潜在思考机制可能需要特权监督来促进有效学习。
图3:LaSER 与基线在 Bright 上跨不同骨干网络和模型大小的性能比较。

5.4 延迟分析
为了解决 RQ3,我们使用单个 NVIDIA A100 (80GB) GPU 在 BRIGHT 基准的 80 个查询子集上评估推理延迟。为了确保严格比较,我们对显式推理流程中的外部检索器模型使用 vLLM [18] 进行推理,而对所有检索器骨干网络(包括我们的)使用原生 Hugging Face Transformers 实现。所有基线和我们的方法均保持批次大小为 8。如图1所示,LaSER 大幅降低了计算成本,仅产生“重写-然后-检索”流程延迟的 ,同时保持了相当的检索有效性。尽管由于潜在思考令牌的自回归生成,LaSER 相比标准基础检索器引入了适度的延迟开销(约为 ),但随着模型规模的增加,这种开销会减少。对于较大的骨干网络,向量操作的相对成本相对于模型的前向传递时间变得微不足道,使得系统能够从 KV 缓存机制中获得更大收益。
5.5 潜在推理步骤的影响
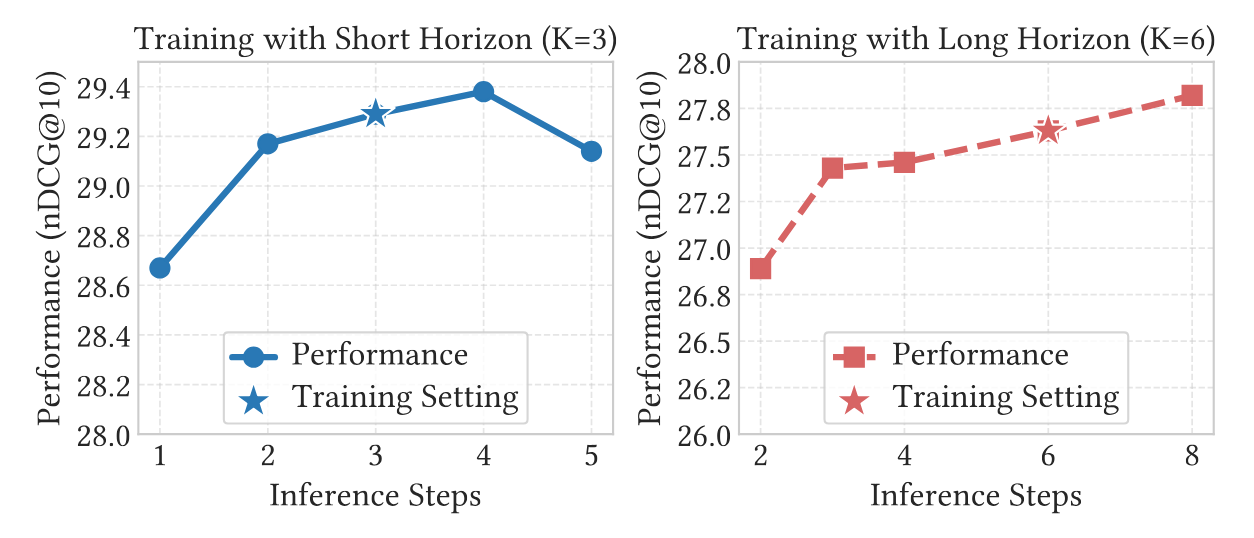
我们研究了在 Qwen3-8B 上,训练和推理期间潜在思考步骤数 的影响,结果如图5所示。
训练效率。 我们观察到,将训练步骤从 增加到 带来的性能提升可以忽略不计,甚至略有下降。我们将此现象归因于我们的框架促进的潜在空间的高语义密度。与标准的隐式推理不同,显式视图的引入提供了特权监督,充当了清晰的优化目标。这使得 LaSER 能够有效地压缩推理过程,其中少量潜在步骤就足以捕获推理路径的核心逻辑。因此,在训练期间强制使用更大的 可能会引入噪声,迫使模型与显式文本中的细粒度、非信息性片段对齐。
推理缩放。 相反,在推理期间增加 表现出一致的性能提升,这突显了 LaSER 已经习得了一种稳健的迭代细化嵌入机制。模型不仅仅是记忆固定的步骤轨迹或复制前面的状态,而是积极利用额外的计算步骤来加深其语义理解并优化查询表示。
图5:训练和推理期间潜在思考步骤的影响。
5.6 双视图协同学习分析
由于我们的框架涉及共享同一骨干网络的两个不同视图的联合训练,我们进一步研究了它们之间的协同交互。具体来说,我们通过比较在推理期间向基础检索器和 LaSER 提供显式重写查询时所获得的性能提升,来评估骨干网络处理显式推理的能力。如图4所示,与基础基线相比,LaSER 从显式重写中获得的性能提升显著更大(例如,在 Qwen3-4B 中为 3.4 对比 1.7)。这一显著差异表明,我们的显式视图训练客观地、有效地优化了共享骨干网络,使其能够更好地捕获和编码 CoT 推理过程中的语义信息以用于检索任务。因此,这种增强的显式处理能力充当了更优的语义上界,从而促进了向潜在视图的更有效蒸馏。
图4:我们的方法与基础训练在 Bright 上使用重写路径的性能比较。

6 结论与未来工作
在本文中,我们提出了 LaSER,一个新颖的自蒸馏框架,它将显式CoT推理内化到密集检索器的潜在空间中。通过采用多粒度对齐策略,将潜在思考令牌与显式推理轨迹同步,LaSER 有效地弥合了深度语义推理与检索效率之间的差距。大量实验表明,LaSER 显著优于最先进的基线模型,达到了与计算昂贵的“重写-然后-检索”流程相当的性能,同时保持了低推理延迟。我们的工作验证了显式推理的语义可以被有效地压缩到潜在状态中,为复杂查询理解提供了一种高效的解决方案。尽管取得了这些令人鼓舞的成果,我们的方法仅代表了迈向完全自主潜在推理的初步一步。在未来的工作中,我们计划探索强化学习技术,通过直接基于检索效用优化潜在推理轨迹,来进一步优化中间的推理过程。
参考文献
[1] Qingyao Ai, Ting Bai, Zhao Cao, Yi Chang, Jiawei Chen, Zhumin Chen, Zhiyong Cheng, Shoubin Dong, Zhicheng Dou, Fuli Feng, Shen Gao, Jiafeng Guo, Xiangnan He, Yanyan Lan, Chenliang Li, Yiqun Liu, Ziyu Lyu, Weizhi Ma, Jun Ma, Zhaochun Ren, Pengjie Ren, Zhiqiang Wang, Mingwen Wang, Ji-Rong Wen, Le Wu, Xin Xin, Jun Xu, Dawei Yin, Peng Zhang, Fan Zhang, Weinan Zhang, Min Zhang, and Xiaofei Zhu. 2023. Information Retrieval meets Large Language Models: A strategic report from Chinese IR community. AI Open 4 (2023), 80–90. doi:10.1016/J.AIOPEN.2023.08.001
[2] Hung-Ting Chen, Xiang Liu, Shauli Ravfogel, and Eunsol Choi. 2025. Beyond Single Embeddings: Capturing Diverse Targets with Multi-Query Retrieval. CoRR abs/2511.02770 (2025). doi:10.48550/ARXIV.2511.02770 arXiv:2511.02770
[3] Jianlyu Chen, Junwei Lan, Chaofan Li, Defu Lian, and Zheng Liu. 2025. ReasonEmbed: Enhanced Text Embeddings for Reasoning-Intensive Document Retrieval. CoRR abs/2510.08252 (2025). doi:10.48550/ARXIV.2510.08252 arXiv:2510.08252
[4] Jianlv Chen, Shitao Xiao, Peitian Zhang, Kun Luo, Defu Lian, and Zheng Liu. 2023. BGE M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings Through Self-Knowledge Distillation. arXiv:2309.07597 [cs.CL]
[5] Xinghao Chen, Anhao Zhao, Heming Xia, Xuan Lu, Hanlin Wang, Yanjun Chen, Wei Zhang, Jian Wang, Wenjie Li, and Xiaoyu Shen. 2025. Reasoning Beyond Language: A Comprehensive Survey on Latent Chain-of-Thought Reasoning. CoRR abs/2505.16782 (2025). doi:10.48550/ARXIV.2505.16782 arXiv:2505.16782
[6] Zijian Chen, Xueguang Ma, Shengyao Zhuang, Ping Nie, Kai Zou, Andrew Liu, Joshua Green, Kshama Patel, Ruoxi Meng, Mingyi Su, Sahel Sharifymoghaddam, Yanxi Li, Haoran Hong, Xinyu Shi, Xuye Liu, Nandan Thakur, Crystina Zhang, Luyu Gao, Wenhu Chen, and Jimmy Lin. 2025. BrowseComp-Plus: A More Fair and Transparent Evaluation Benchmark of Deep-Research Agent. CoRR abs/2508.06600 (2025). doi:10.48550/ARXIV.2508.06600 arXiv:2508.06600
[7] Xuanming Cui, Jianpeng Cheng, Hong-you Chen, Satya Narayan Shukla, Abhijeet Awasthi, Xichen Pan, Chaitanya Ahuja, Shlok Kumar Mishra, Yonghuan Yang, Jun Xiao, Qi Guo, Ser-Nam Lim, Aashu Singh, and Xiangjun Fan. 2025. Think Then Embed: Generative Context Improves Multimodal Embedding. CoRR abs/2510.05014 (2025). doi:10.48550/ARXIV.2510.05014 arXiv:2510.05014
[8] Debrup Das, Seán Ó Nualláin, and Razieh Rahimi. 2025. RaDeR: Reasoning-aware Dense Retrieval Models. CoRR abs/2505.18405 (2025). doi:10.48550/ARXIV.2505.18405 arXiv:2505.18405
[9] Luyu Gao, Xueguang Ma, Jimmy Lin, and Jamie Callan. 2023. Precise Zero-Shot Dense Retrieval without Relevance Labels. In Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), ACL 2023, Toronto, Canada, July 9-14, 2023, Anna Rogers, Jordan L. Boyd-Graber, and Naoaki Okazaki (Eds.). Association for Computational Linguistics, 1762–1777. doi:10.18653/V1/2023.ACL-LONG.99
[10] Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, Qianyu Guo, Meng Wang, and Haofen Wang. 2024. Retrieval-Augmented Generation for Large Language Models: A Survey. arXiv:2312.10997 [cs.CL]
[11] Yuntao Gui and James Cheng. 2025. Search-R3: Unifying Reasoning and Embedding Generation in Large Language Models. CoRR abs/2510.07048 (2025). doi:10.48550/ARXIV.2510.07048 arXiv:2510.07048
[12] Shibo Hao, Sainbayar Sukhbaatar, DiJia Su, Xian Li, Zhiting Hu, Jason Weston, and Yuandong Tian. 2024. Training Large Language Models to Reason in a Continuous Latent Space. CoRR abs/2412.06769 (2024). doi:10.48550/ARXIV.2412.06769 arXiv:2412.06769
[13] Xanh Ho, Anh-Khoa Duong Nguyen, Saku Sugawara, and Akiko Aizawa. 2020. Constructing A Multi-hop QA Dataset for Comprehensive Evaluation of Reasoning Steps. In Proceedings of the 28th International Conference on Computational Linguistics, COLING 2020, Barcelona, Spain (Online), December 8-13, 2020, Donia Scott, Núria Bel, and Chengqing Zong (Eds.). International Committee on Computational Linguistics, 6609–6625. doi:10.18653/V1/2020.COLING-MAIN.580
[14] Aaron Hurst, Adam Lerer, Adam P Goucher, Adam Perelman, Aditya Ramesh, Aidan Clark, AJ Ostrow, Akila Welihinda, Alan Hayes, Alec Radford, et al. 2024. Gpt-4o system card. arXiv preprint arXiv:2410.21276 (2024).
[15] Gautier Izacard, Mathilde Caron, Lucas Hosseini, Sebastian Riedel, Piotr Bojanowski, Armand Joulin, and Edouard Grave. 2022. Unsupervised Dense Information Retrieval with Contrastive Learning. Trans. Mach. Learn. Res. 2022 (2022). https://openreview.net/forum?id=jKN1pXi7b0
[16] Vladimir Karpukhin, Barlas Oguz, Sewon Min, Patrick Lewis, Ledell Wu, Sergey Edunov, Danqi Chen, and Wen-tau Yih. 2020. Dense Passage Retrieval for Open-Domain Question Answering. In EMNLP. 6769–6781.
[17] Jacob Devlin Ming-Wei Chang Kenton and Lee Kristina Toutanova. 2019. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. In NAACL-HLT. 4171–4186.
[18] Woosuk Kwon, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. 2023. Efficient Memory Management for Large Language Model Serving with PagedAttention. In Proceedings of the 29th Symposium on Operating Systems Principles, SOSP 2023, Koblenz, Germany, October 23-26, 2023, Jason Flinn, Margo I. Seltzer, Peter Druschel, Antoine Kaufmann, and Jonathan Mace (Eds.). ACM, 611–626. doi:10.1145/3600006.3613165
[19] Chankyu Lee, Rajarshi Roy, Mengyao Xu, Jonathan Raiman, Mohammad Shoeybi, Bryan Catanzaro, and Wei Ping. 2025. NV-Embed: Improved Techniques for Training LLMs as Generalist Embedding Models. In The Thirteenth International Conference on Learning Representations, ICLR 2025, Singapore, April 24-28, 2025. OpenReview.net. https://openreview.net/forum?id=lgsyLSsDRe
[20] Patrick S. H. Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Küttler, Mike Lewis, Wen tau Yih, Tim Rocktäschel, Sebastian Riedel, and Douwe Kiela. 2020. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. In Advances in Neural Information Processing Systems 33: Annual Conference on Neural Information Processing Systems 2020, NeurIPS 2020, December 6-12, 2020, virtual. https://proceedings.neurips.cc/paper/2020/hash/6b493230205f780e1bc26945df7481e5-Abstract.html
[21] Zehan Li, Xin Zhang, Yanzhao Zhang, Dingkun Long, Pengjun Xie, and Meishan Zhang. 2023. Towards General Text Embeddings with Multi-stage Contrastive Learning. CoRR abs/2308.03281 (2023). doi:10.48550/ARXIV.2308.03281 arXiv:2308.03281
[22] Zhengyang Liang, Meiyu Liang, Wei Huang, Yawen Li, and Zhe Xue. 2024. Dynamic Self-adaptive Multiscale Distillation from Pre-trained Multimodal Large Model for Efficient Cross-modal Representation Learning. CoRR abs/2404.10838 (2024). doi:10.48550/ARXIV.2404.10838 arXiv:2404.10838
[23] Wenhan Liu, Xinyu Ma, Weiwei Sun, Yutao Zhu, Yuchen Li, Dawei Yin, and Zhicheng Dou. 2025. ReasonRank: Empowering Passage Ranking with Strong Reasoning Ability. CoRR abs/2508.07050 (2025). doi:10.48550/ARXIV.2508.07050 arXiv:2508.07050
[24] Amir M. Mansourian, Rozhan Ahmadi, Masoud Ghafouri, Amir Mohammad Babaei, Elaheh Badali Golezani, Zeynab Yasamani Ghamchi, Vida Ramezanian, Alireza Taherian, Kimia Dinashi, Amirali Miri, and Shohreh Kasaei. 2025. A Comprehensive Survey on Knowledge Distillation. Trans. Mach. Learn. Res. 2025 (2025). https://openreview.net/forum?id=3cbJzdR78B
[25] Sewon Min, Julian Michael, Hannaneh Hajishirzi, and Luke Zettlemoyer. 2020. AmbigQA: Answering Ambiguous Open-domain Questions. In Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing, EMNLP 2020, Online, November 16-20, 2020, Bonnie Webber, Trevor Cohn, Yulan He, and Yang Liu (Eds.). Association for Computational Linguistics, 5783–5797. doi:10.18653/V1/2020.EMNLP-MAIN.466
[26] Fengran Mo, Kelong Mao, Ziliang Zhao, Hongjin Qian, Haonan Chen, Yiruo Cheng, Xiaoxi Li, Yutao Zhu, Zhicheng Dou, and Jian-Yun Nie. 2025. A Survey of Conversational Search. ACM Trans. Inf. Syst. 43, 6 (2025), 167:1–167:50. doi:10.1145/3759453
[27] Niklas Muennighoff, Hongjin Su, Liang Wang, Nan Yang, Furu Wei, Tao Yu, Amanpreet Singh, and Douwe Kiela. 2024. Generative Representational Instruction Tuning. CoRR abs/2402.09906 (2024). doi:10.48550/ARXIV.2402.09906 arXiv:2402.09906
[28] Letian Peng, Yuwei Zhang, Zilong Wang, Jayanth Srinivasa, Gaowen Liu, Zihan Wang, and Jingbo Shang. 2024. Answer is All You Need: Instruction-following Text Embedding via Answering the Question. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), ACL 2024, Bangkok, Thailand, August 11-16, 2024, Lun-Wei Ku, Andre Martins, and Vivek Srikumar (Eds.). Association for Computational Linguistics, 459–477. doi:10.18653/V1/2024.ACL-LONG.27
[29] Xubo Qin, Jun Bai, Jiaqi Li, Zixia Jia, and Zilong Zheng. 2025. TongSearch-QR: Reinforced Query Reasoning for Retrieval. CoRR abs/2506.11603 (2025). doi:10.48550/ARXIV.2506.11603 arXiv:2506.11603
[30] Rulin Shao, Rui Qiao, Varsha Kishore, Niklas Muennighoff, Xi Victoria Lin, Daniela Rus, Bryan Kian Hsiang Low, Sewon Min, Wen-tau Yih, Pang Wei Koh, and Luke Zettlemoyer. 2025. ReasonIR: Training Retrievers for Reasoning Tasks. CoRR abs/2504.20595 (2025). doi:10.48550/ARXIV.2504.20595 arXiv:2504.20595
[31] Zhenyi Shen, Hanqi Yan, Linhai Zhang, Zhanghao Hu, Yali Du, and Yulan He. 2025. CODI: Compressing Chain-of-Thought into Continuous Space via Self-Distillation. CoRR abs/2502.21074 (2025). doi:10.48550/ARXIV.2502.21074 arXiv:2502.21074
[32] Hongjin Su, Howard Yen, Mengzhou Xia, Weijia Shi, Niklas Muennighoff, Han-yu Wang, Haisu Liu, Quan Shi, Zachary S. Siegel, Michael Tang, Ruoxi Sun, Jinsung Yoon, Sercan Ö. Arik, Danqi Chen, and Tao Yu. 2025. BRIGHT: A Realistic and Challenging Benchmark for Reasoning-Intensive Retrieval. In The Thirteenth International Conference on Learning Representations, ICLR 2025, Singapore, April 24-28, 2025. OpenReview.net. https://openreview.net/forum?id=ykuc5q381b
[33] Jiashuo Sun, Shixuan Liu, Zhaochen Su, Xianrui Zhong, Pengcheng Jiang, Bowen Jin, Peiran Li, Weijia Shi, and Jiawei Han. 2025. GRACE: Generative Representation Learning via Contrastive Policy Optimization. CoRR abs/2510.04506 (2025). doi:10.48550/ARXIV.2510.04506 arXiv:2510.04506
[34] Yu-Che Tsai, Kuan-Yu Chen, Yuan-Chi Li, Yuan-Hao Chen, Ching-Yu Tsai, and Shou-De Lin. 2025. Let LLMs Speak Embedding Languages: Generative Text Embeddings via Iterative Contrastive Refinement. CoRR abs/2509.24291 (2025). doi:10.48550/ARXIV.2509.24291 arXiv:2509.24291
[35] Liang Wang, Nan Yang, Xiaolong Huang, Binxing Jiao, Linjun Yang, Daxin Jiang, Rangan Majumder, and Furu Wei. 2022. Text Embeddings by Weakly-Supervised Contrastive Pre-training. CoRR abs/2212.03533 (2022). doi:10.48550/ARXIV.2212.03533 arXiv:2212.03533
[36] Liang Wang, Nan Yang, Xiaolong Huang, Linjun Yang, Rangan Majumder, and Furu Wei. 2024. Improving Text Embeddings with Large Language Models. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), ACL 2024, Bangkok, Thailand, August 11-16, 2024, Lun-Wei Ku, Andre Martins, and Vivek Srikumar (Eds.). Association for Computational Linguistics, 11897-11916. doi:10.18653/V1/2024.ACL-LONG.642
[37] Liang Wang, Nan Yang, and Furu Wei. 2023. Query2doc: Query Expansion with Large Language Models. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, EMNLP 2023, Singapore, December 6-10, 2023, Houda Bouamor, Juan Pino, and Kalika Bali (Eds.). Association for Computational Linguistics, 9414-9423. doi:10.18653/V1/2023.EMNLP-MAIN.585
[38] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Ed H. Chi, Quoc Le, and Denny Zhou. 2022. Chain of Thought Prompting Elicits Reasoning in Large Language Models. CoRR abs/2201.11903 (2022). arXiv:2201.11903 https://arxiv.org/abs/2201.11903
[39] Orion Weller, Benjamin Chang, Sean MacAvaney, Kyle Lo, Arman Cohan, Benjamin Van Durme, Dawn J. Lawrie, and Luca Soldaini. 2025. FollowIR: Evaluating and Teaching Information Retrieval Models to Follow Instructions. In Proceedings of the 2025 Conference of the Nations of the Americas Chapter of the Association for Computational Linguistics: Human Language Technologies, NAACL 2025 - Volume 1: Long Papers, Albuquerque, New Mexico, USA, April 29 - May 4, 2025, Luis Chiruzzo, Alan Ritter, and Lu Wang (Eds.). Association for Computational Linguistics, 11926-11942. doi:10.18653/V1/2025.NAACL-LONG.597
[40] Shitao Xiao, Zheng Liu, Peitian Zhang, Niklas Muennighoff, Defu Lian, and Jian-Yun Nie. 2024. C-Pack: Packed Resources For General Chinese Embeddings. In Proceedings of the 47th International ACM SIGIR Conference on Research and Development in Information Retrieval, SIGIR 2024, Washington DC, USA, July 14-18, 2024, Grace Hui Yang, Hongning Wang, Sam Han, Claudia Hauff, Guido Zuccon, and Yi Zhang (Eds.). ACM, 641-649. doi:10.1145/3626772.3657878
[41] Seunghan Yang, Juntae Lee, Jihwan Bang, Kyuhong Shim, Minsoo Kim, and Simyung Chang. 2025. Learning Contextual Retrieval for Robust Conversational Search. In Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing, Christos Christodoulopoulos, Tanmoy Chakraborty, Carolyn Rose, and Violet Peng (Eds.). Association for Computational Linguistics, Suzhou, China, 11991-12003. doi:10.18653/v1/2025.emnlp-main.602
[42] Zhilin Yang, Peng Qi, Saizheng Zhang, Yoshua Bengio, William Cohen, Ruslan Salakhutdinov, and Christopher D. Manning. 2018. HotpotQA: A Dataset for Diverse, Explainable Multi-hop Question Answering. In EMNLP. Association for Computational Linguistics, Brussels, Belgium, 2369-2380. doi:10.18653/v1/D18-1259
[43] Sijia Yao, Pengcheng Huang, Zhenghao Liu, Yu Gu, Yukun Yan, Shi Yu, and Ge Yu. 2025. ExpandR: Teaching Dense Retrievers Beyond Queries with LLM Guidance. In Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing, Christos Christodoulopoulos, Tanmoy Chakraborty, Carolyn Rose, and Violet Peng (Eds.). Association for Computational Linguistics, Suzhou, China, 19036-19054. doi:10.18653/v1/2025.emnlp-main.963
[44] Dun Zhang and Fulong Wang. 2024. Jasper and Stella: distillation of SOTA embedding models. CoRR abs/2412.19048 (2024). doi:10.48550/ARXIV.2412.19048 arXiv:2412.19048
[45] Yichi Zhang, Jun Bai, Zhixin Cai, Shuhan Qin, Zhuofan Chen, Jinghua Guan, and Wenge Rong. 2025. Your Dense Retriever is Secretly an Expeditious Reasoner. CoRR abs/2510.21727 (2025). doi:10.48550/ARXIV.2510.21727 arXiv:2510.21727
[46] Yanzhao Zhang, Mingxin Li, Dingkun Long, Xin Zhang, Huan Lin, Baosong Yang, Pengjun Xie, An Yang, Dayiheng Liu, Junyang Lin, Fei Huang, and Jingren Zhou. 2025. Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models. CoRR abs/2506.05176 (2025). doi:10.48550/ARXIV.2506.05176 arXiv:2506.05176
[47] Wayne Xin Zhao, Kun Zhou, Junyi Li, Tianyi Tang, Xiaolei Wang, Yupeng Hou, Yingqian Min, Beichen Zhang, Junjie Zhang, Zican Dong, Yifan Du, Chen Yang, Yushuo Chen, Zhipeng Chen, Jinhao Jiang, Ruiyang Ren, Yifan Li, Xinyu Tang, Zikang Liu, Peiyu Liu, Jian-Yun Nie, and Ji-Rong Wen. 2023. A Survey of Large Language Models. CoRR abs/2303.18223 (2023). doi:10.48550/ARXIV.2303.18223 arXiv:2303.18223
[48] Ziliang Zhao, Changle Qu, Zhicheng Dou, Haonan Chen, and Jiajie Jin. 2025. Retrieving Intent-covering Demonstrations for Clarification Generation in Conversational Search Systems. In Proceedings of the 31st ACM SIGKDD Conference on Knowledge Discovery and Data Mining, V.2, KDD 2025, Toronto ON, Canada, August 3-7, 2025, Luiza Antonio, Jian Pei, Xiaohui Yu, Flavio Chierichetti, Hady W. Lauw, Yizhou Sun, and Srinivasan Parthasarathy (Eds.). ACM, 3992-4001. doi:10.1145/3711896.3737104
[49] Yutao Zhu, Huaying Yuan, Shuting Wang, Jiongnan Liu, Wenhan Liu, Chenlong Deng, Zhicheng Dou, and Ji-Rong Wen. 2023. Large Language Models for Information Retrieval: A Survey. CoRR abs/2308.07107 (2023). doi:10.48550/ARXIV.2308.07107 arXiv:2308.07107